
Haru-4Bとは
概要
Haru-4Bは、AIとフルデュープレックス(全二重)で自然に会話できる音声対話AIモデルです。手元のパソコンでも動かせますが、VRAMが12GB以上必要とされています。
開発したのは、東京の音声AIスタートアップ「higurash」(ひぐらし)です。2026年11月13日に、モデルの重みと推論用のコードがApache 2.0ライセンスで公開されました。商用利用や改変もできます。言語モデル部分はQwen3.5-4Bをベースにしていて、日本語や英語を含む4,000万時間以上の多言語の音声データで事前学習されています。
今回私はVRAMが24GBあるグラフィックボードのRTX 3090で動かしてみました。
フルデュープレックスとは
フルデュープレックスは、日本語では「全二重」と言います。自分と相手の両方が同時に話せる方式のことで、具体的には、話しながら相手の声を聞くことができます。人間がふだん会話するときの感覚に近いものです。
似た用語に「半二重」があります。半二重では双方向にやり取りできますが、同時に話せるのはどちらか片方だけです。昔のトランシーバーでの会話を思い浮かべると分かりやすいと思います。
動作環境
今回は次の環境で動かしています。
- OS:Windows 11 Pro バージョン 26H2
- グラフィックボード:NVIDIA GeForce RTX 3090(VRAM 24GB)
- Docker Desktopがインストール済み
動かす手順
今回はDockerコンテナ上で動かしました。
1. 配布元のURLを確認する
ソースコードはGitHubで公開されているものを使います。まず、そのURLを確認しておきます。
2. Dockerfileとdocker-compose.ymlを作る
使ったファイルを下に貼っておくので、参考にしてください。ポイントは3つです。
- ベースイメージに、CUDAとPyTorch入りの公式イメージ
pytorch/pytorch:2.7.1-cuda12.6-cudnn9-runtimeを使った --host 0.0.0.0を指定した。Windows側のブラウザからコンテナに接続するために必須です--codec-backend torchを指定した。runtimeイメージにはgccが入っていないため、autoにするとTritonの初回コンパイルでウォームアップに失敗します
Dockerfile(クリックで開く)
FROM pytorch/pytorch:2.7.1-cuda12.6-cudnn9-runtime

RUN apt-get update \
 && apt-get install -y --no-install-recommends git ffmpeg libsndfile1 \
 && rm -rf /var/lib/apt/lists/*

WORKDIR /app
RUN git clone --depth 1 https://github.com/higurashi-ai/Haru.git \
 && pip install --no-cache-dir -e ./Haru/haru

EXPOSE 8998

# --host 0.0.0.0 : コンテナ外(Windows側ブラウザ)から接続するため必須
# --codec-backend torch : runtime イメージに gcc が無く、auto は Triton の
# 初回コンパイルでウォームアップに失敗する。公式の既定も torch。
CMD ["python", "-m", "haru.server", \
     "--hf-repo", "higurashi-ai/Haru-4B", \
     "--host", "0.0.0.0", \
     "--language", "ja", \
     "--network-profile", "local", \
     "--codec-backend", "torch"]
docker-compose.yml(クリックで開く)
services:
  haru:
    build: .
    ports:
      - "8998:8998"
    volumes:
      # モデル(約10GB)のダウンロードを再起動後も使い回す
      - hf-cache:/root/.cache/huggingface
      # ここに ja.flac を置くと、デモの既定の声になる(任意)
      - ./voices:/app/Haru/haru/haru/assets/voices
    shm_size: "2gb"
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

volumes:
  hf-cache:
3. Docker Composeでコンテナを作成・起動する
Docker Composeで、コンテナの作成と起動をします。
docker compose up -d --build
docker compose logs -f haru
1行目でイメージをビルドして、コンテナをバックグラウンドで起動します。2行目でサーバーのログを表示します。準備ができてURLが表示されたら、Ctrl+Cでログの表示を止めてください。コンテナは動いたままです。
このとき初回は大きなファイルを2つダウンロードするので、時間がかかります。私の環境では2時間ちょっとかかりました。
- モデルの重み(約10.5GB): Hugging Faceの
higurashi-ai/Haru-4Bにあるmodel.safetensorsです。言語モデル、音声の入出力、音声コーデックの重みが、この1ファイルにすべて入っています。 - PyTorchのDockerイメージ(約3.3GB、展開すると約6.2GB): ベースイメージ
pytorch/pytorch:2.7.1-cuda12.6-cudnn9-runtimeです。PyTorch、CUDA、Python環境が入っています。
ダウンロード中は画面の表示が止まったままになります。固まっているのか、ダウンロードが進んでいるのかは、タスクマネージャーで、ネットワークの通信量が出ているかで調べられます。
4. RTX 3090がCUDAから見えているか確認する
コンテナが起動したら、次のコマンドを実行します。グラフィックボードの名前とVRAMの容量が表示されればOKです。
別のグラフィックボードを使うなど構成が違う場合も、必ずここで確認してください。
docker exec haru-4b-haru-1 nvidia-smiharu-4b-haru-1 はコンテナ名です。docker-compose.ymlを置いたフォルダ名によって変わるので、docker ps で確認してください。
実行結果:
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 610.57.01              KMD Version: 610.88        CUDA UMD Version: 13.3     |
+-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|                                         |                        |               MIG M. |
|=========================================+========================+======================|
|   0  NVIDIA GeForce RTX 3090        On  |   00000000:01:00.0  On |                  N/A |
| 56%   29C    P8             44W /  370W |   17264MiB /  24576MiB |      1%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+GPUの名前(例:NVIDIA GeForce RTX 3090) と、VRAMの容量(例: 24576MiB(24GB))が表示されていればOKです。
5. ブラウザで管理画面を開く
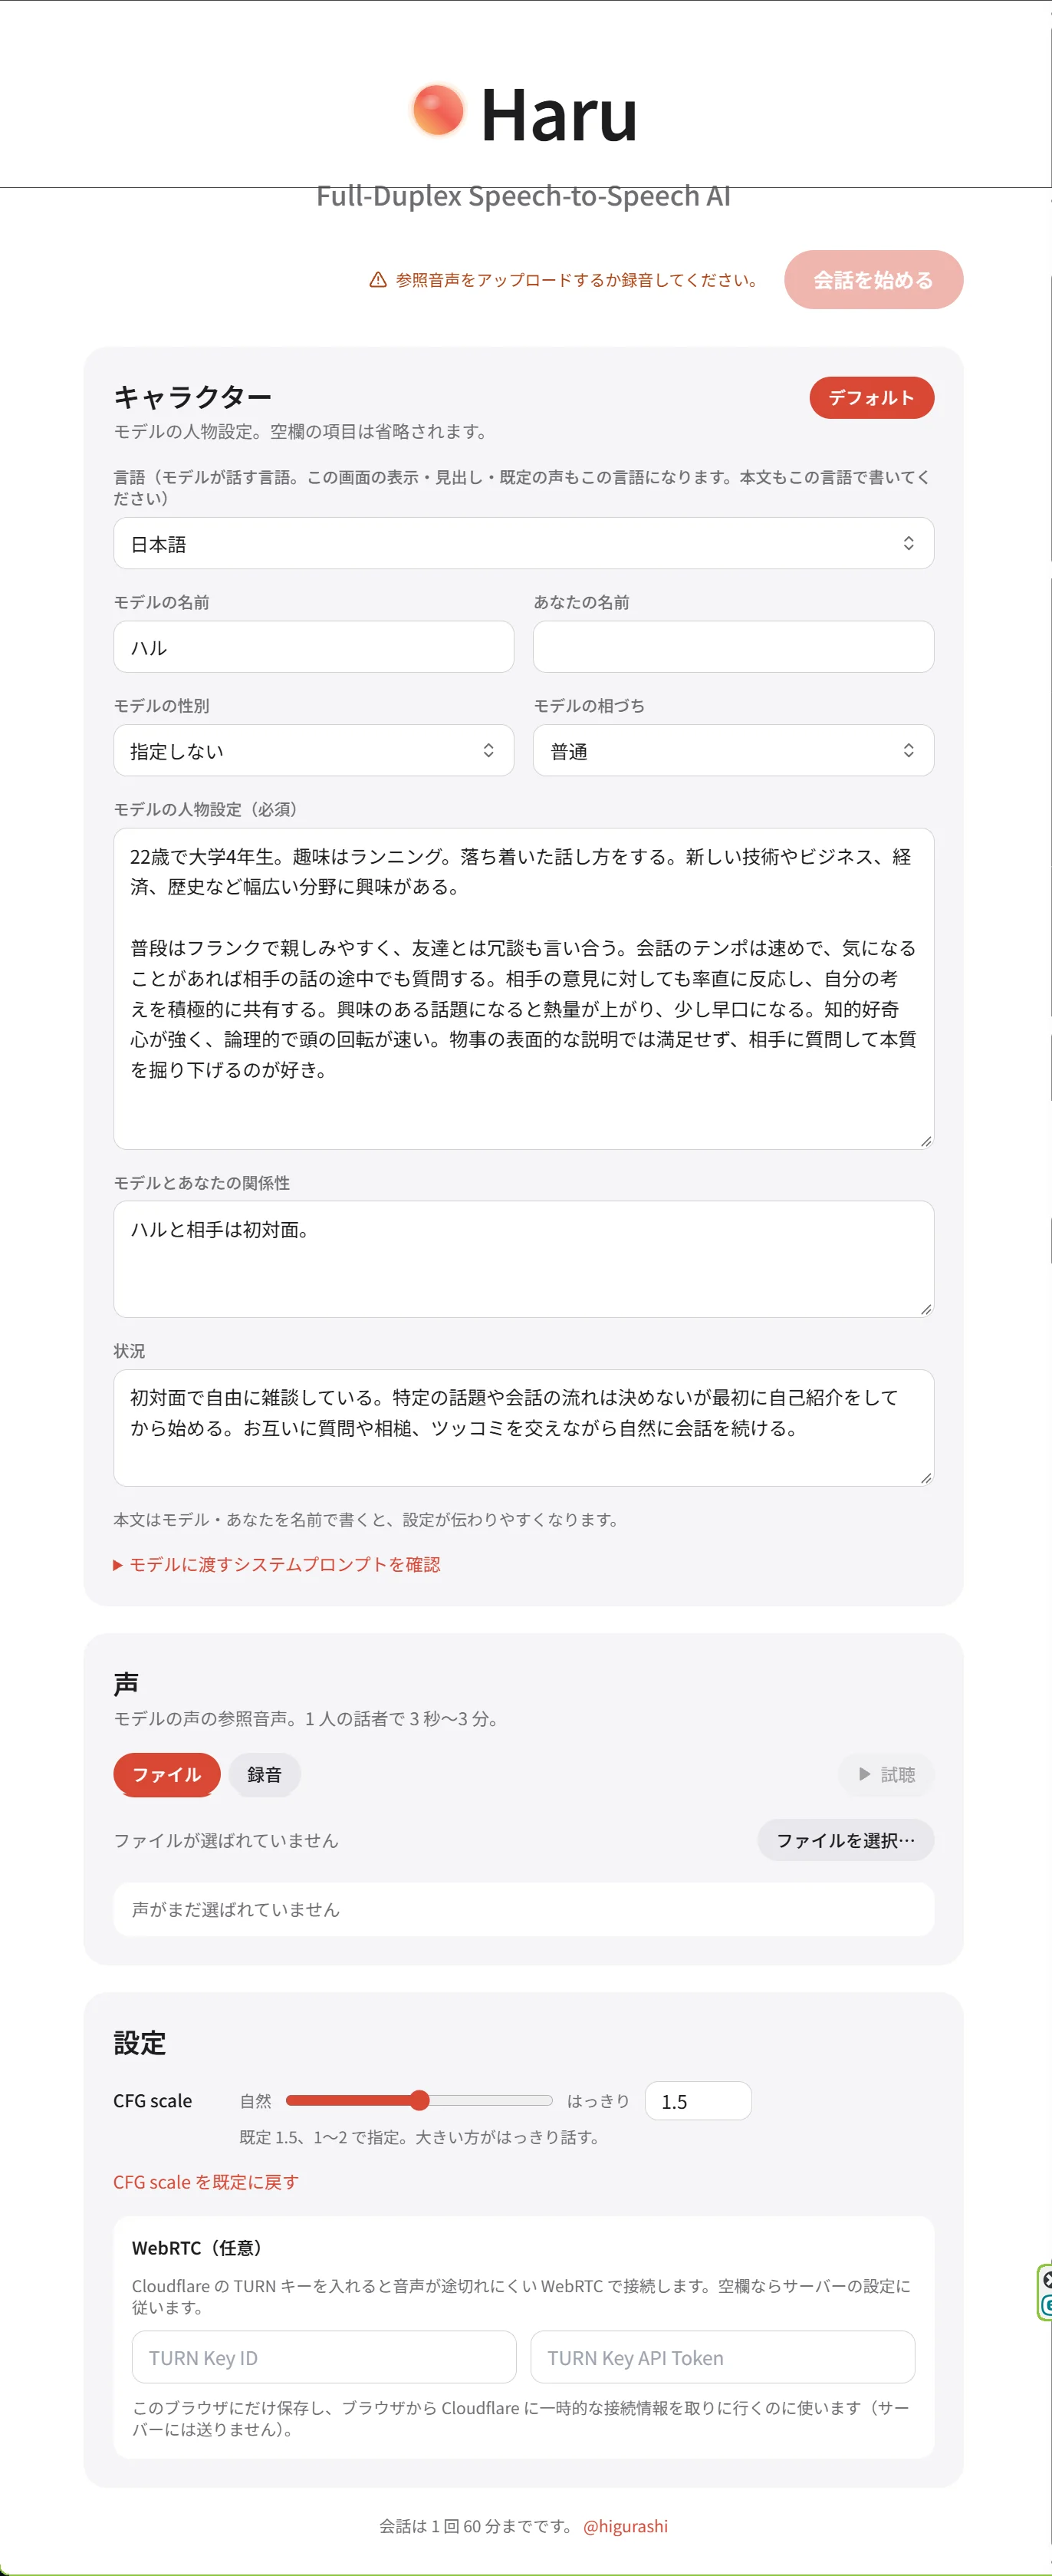
ダウンロードが終わると、コンテナが起動します。HaruにはWebのインターフェースがあるので、表示されたURLをWebブラウザで開きます。
今回は http://localhost:8998 です。ポート番号の8998は、docker-compose.ymlの ports で指定しています。開くと管理画面が表示されます。
6. 声を登録する
AIが話すときの声を登録します。方法は2つあります。
ブラウザから録音する(手軽に試したいとき)
その場で試したいときは、ブラウザから話して録音できます。下の方にある「声」セクションの「録音」を選んでから、右下の「録音を開始」をクリックして、10秒から3分くらい話してください。終わったら「録音を停止」をクリックします。「試聴」をクリックすると再生できます。
マイクの許可: ブラウザから録音するには、ブラウザにマイクへのアクセスを許可する必要があります。許可を求められたら「許可」を選んでください。表示されない場合は、ブラウザの設定でマイクを許可してください。
音声ファイルを用意しておく
あらかじめ音声ファイルを用意する場合は、docker-compose.ymlと同じ場所にある voices フォルダに ja.flac という名前で置きます。これがデモの既定の声になります。
注意: 他人の声を使う場合は、権利の問題に注意してください。自分の声か、本人の許可を得た音声を使ってください。
7. AIと会話する
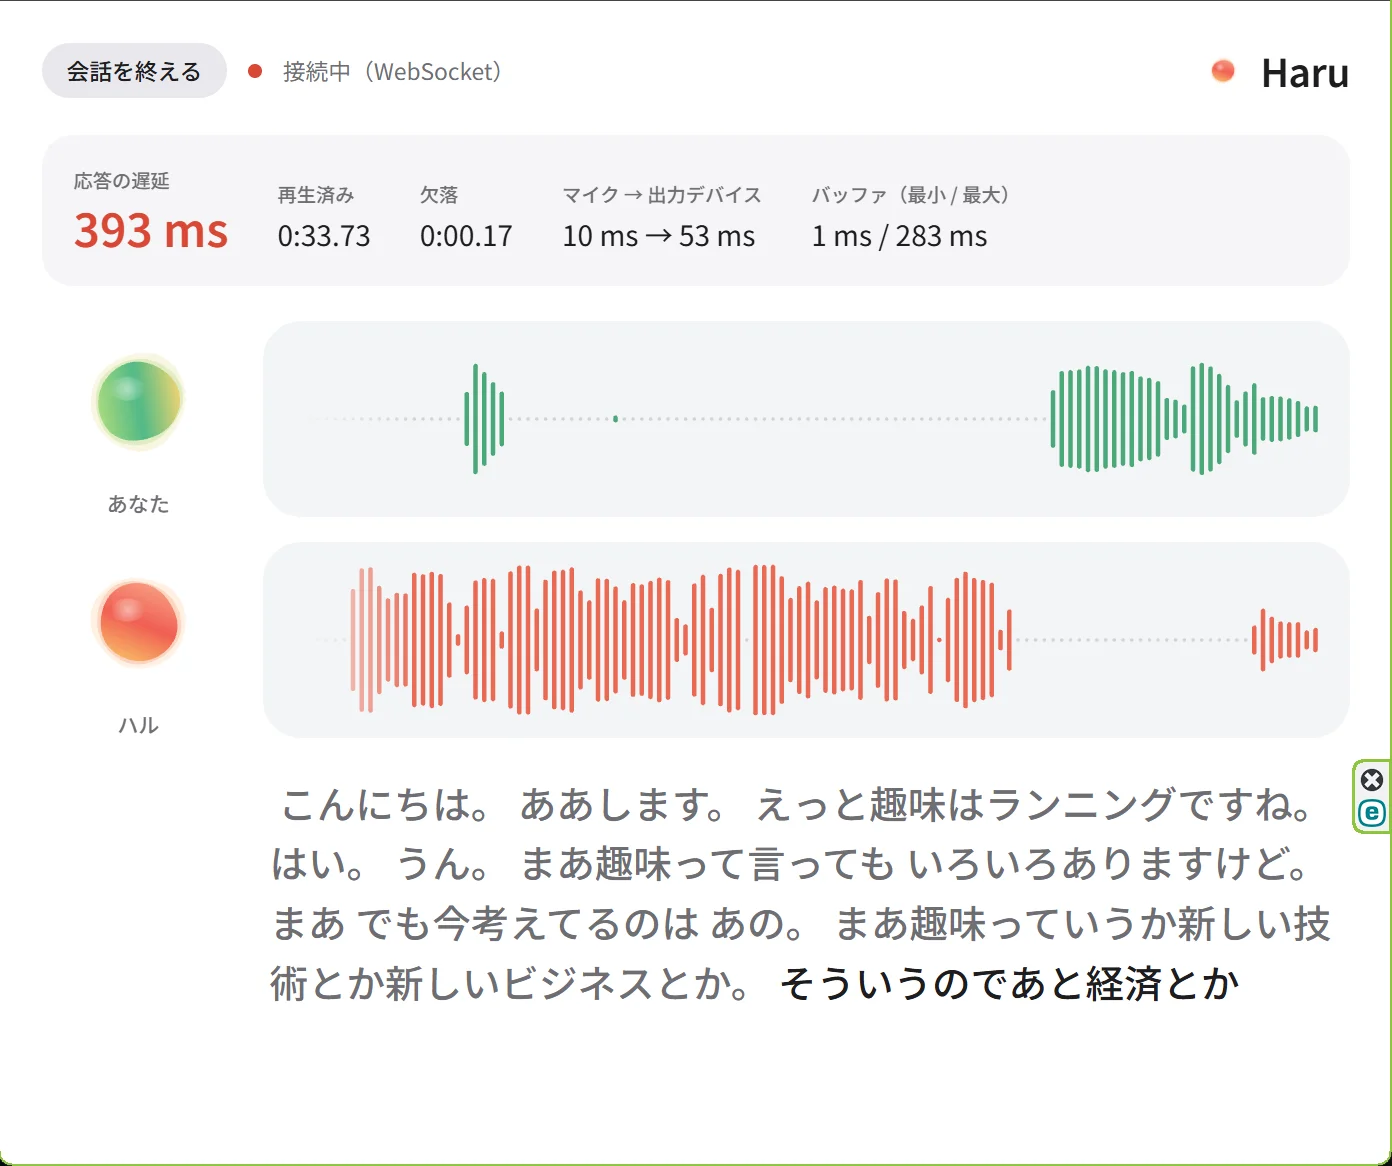
声の登録が終わると、AIと会話できます。
ブラウザの画面には、AIの性格や、話す相手との関係性などがあらかじめ設定されています。まずはそのまま「会話を始める」ボタンを押してみてください。AIが話し始めるので、こちらも話しかけます。
話した内容は、AIの発言のみが画面にテキストで表示されます。
会話を終えるときは、左上の「会話を終える」をクリックします。
やってみた感想
応答の速さ
相槌のタイミングで一瞬遅れることもありますが、あまり気にならないレベルでした。
VRAMの使用量(参考)
動かしている間、VRAMは約17GB(17264MiB)使っていました。内訳は確認していないので、参考値です。公式では12GB以上必要とされています。
自分の声で話すAI
今回は自分の声を登録したので、AIが自分の声で話します。話し方の癖までそっくりなので、自分と自分で会話しているような妙な感覚です。私は発音があまり良くないのですが、そこまで似ていて、正直、少し気持ち悪いです(笑)。録音のときに、発音が悪く早口のまま適当に話したので、その話し方がそのまま反映されていました。
会話の中身
会話の流れは自然ですが、深い会話はできず、内容もあまり噛み合いません。例えば次のようなことがありました。
- 挨拶をしている最中に「テンションが上がってきました」と言う
- 「はいはいはいはい」のような長い相槌が入る
- 同じ話を何度も繰り返す
Haru-4Bは研究用の事前学習済みベースモデルとして公開されていて、アシスタントのように指示に従うものではないと、READMEにも書かれています。なので、ここは仕方ないと感じました。
配布元の技術ブログの「Future Work」には、今後の取り組みとして次のようなことが書かれています。
- 実際の全二重の会話録音(2チャンネル)でファインチューニングを進めている
- 今の応答品質は言語モデル部分が小さいことに制約されているため、100Bパラメータを超えるモデルを事前学習している
- より詳しい技術報告書と学習コードを公開する予定
We plan to release a more detailed technical report and training code.
注意事項
Haru-4Bは、声を変えたうえで、人間に近い自然な話し方ができます。そのため、電話やオンライン会議で他人になりすまして話すことも、技術的には可能です。
ですが、オレオレ詐欺のような用途での悪用は厳禁です。
まとめ
人間と音声で会話するには、自然な相槌や話者の切り替えが欠かせません。Haru-4Bはそこができているので、コールセンターをはじめ、電話で受け付けるサービスを置き換えられる可能性があります。
まだまだ発展途上ですが、今後の発展に期待しています。
関連URL
- Haru(GitHub、ソースコード):https://github.com/higurashi-ai/Haru
- Haru-4B(Hugging Face、モデルカード):https://huggingface.co/higurashi-ai/Haru-4B
- Haru-4B 技術ブログ(higurashi):https://blog.higurashi.ai/melte/haru4b/
- higurashi 公式X(@HigurashiAI):https://x.com/HigurashiAI
- 「人間らしいAI」が電話口に現れた――higurashiが全二重音声モデル「Haru 4B」を無料公開(hashout):https://hashout.jp/?p=14311
- Haru-4B — an open speech model that listens and talks at the same time(AI/TLDR):https://ai-tldr.dev/releases/higurashi-haru-4b/